 ناب لرنینگ |
بزرگترین بانک اطلاعاتی پروژه های دانشجویی
انتخاب ویژگی یا Feature Selection
برای مساله انتخاب ویژگی، راه حل ها و
الگوریتم های فراوانی ارائه شده است که بعضی از آن ها قدمت سی یا چهل ساله دارند.
مشکل بعضی از الگوریتم ها در زمانی که ارائه شده بودند، بار محاسباتی زیاد آن ها
بود، اگر چه امروزه با ظهور کامپیوترهای سریع و منابع ذخیره سازی بزرگ، این مشکل
به چشم نمی آید ولی از طرف دیگر، مجموعه های دادهای بسیار بزرگ برای مسائل جدید
باعث شده است که همچنان پیدا کردن یک الگوریتم سریع برای این کار مهم باشد. مساله
انتخاب ویژگی به وسیله نویسندگان مختلف، از دیدگاه های متفاوتی مورد بررسی قرار
گرفته است. هر نویسنده نیز با توجه به نوع کاربرد، تعریفی را از آن ارائه داده
است. در ادامه چند مورد از این تعاریف را بیان میکنیم:
1- تعریف ایده آل:
پیدا کردن یک زیرمجموعه با حداقل
اندازه ممکن، برای ویژگی ها است، که برای هدف موردنظر اطلاعات لازم و کافی را در
بر داشته باشد. بدیهی است که هدف تمام الگوریتم ها و روشهای انتخاب ویژگی، همین
زیر مجموعه است.
2- تعریف کلاسیک:
انتخاب یک زیرمجموعه M عنصری از میان N ویژگی، به طوریکه M < N باشد و مقدار یک تابع معیار (Criterion
Function) برای زیرمجموعه موردنظر، نسبت به سایر
زیرمجموعه های هماندازه دیگر بهینه باشد. این تعریفی است که
Fukunaga و
Narenda در سال 1111 ارائه داده اند.
3- افزایش دقت پیشگوئی : هدف انتخاب
ویژگی این است که یک زیرمجموعه از ویژگی ها برای افزایش دقت پیشگوئی، انتخاب شوند.
به عبارت دیگر کاهش اندازه ساختار بدون کاهش قابل ملاحظه در دقت پیشگوئی طبقه بندی
کنندهای که با استفاده از ویژگی های داده شده بدست می آید، صورت گیرد.
4- تخمین توزیع کلاس اصلی:
هدف از انتخاب ویژگی این است که یک
زیرمجموعه کوچک از ویژگی ها انتخاب شوند، توزیع ویژگی هایی که انتخاب میشوند،
بایستی تا حد امکان به توزیع کلاس اصلی با توجه به تمام مقادیر ویژگی های انتخاب
شده نزدیک باشد.
روش های مختلف انتخاب ویژگی، تلاش
میکنند تا از میان زیر مجموعه کاندید، بهترین زیرمجموعه را پیدا کنند. در تمام این
روش ها براساس کاربرد و نوع تعریف، زیر مجموعه ای به عنوان جواب انتخاب میشود، که
بتواند مقدار یک تابع ارزیابی را بهینه کند. با وجود این که هر روشی سعی می کند که
بتواند، بهترین ویژگی ها را انتخاب کند، اما با توجه به وسعت جواب های ممکن، و این
که این مجموعه های جواب به صورت توانی با
N افزایش پیدا می کنند، پیدا کردن جواب
بهینه مشکل و در Nهای متوسط و بزرگ بسیار پر هزینه است.
به طور کلی روش های مختلف انتخاب ویژگی را براساس نوع جستجو به دسته های مختلفی
تقسیم بندی می کنند. در بعضی روشها تمام فضای ممکن جستجو میگردد. در سایر روشها که
میتواند مکاشفه ای و یا جستجوی تصادفی باشد، در ازای از دست دادن مقداری از
کارایی، فضای جستجو کوچکتر میشود.
روش های مختلف انتخاب ویژگی
تکنیک های انتخاب ویژگی را می توان به دو شیوه دسته بندی کرد : در یک شیوه، روش های مختلف انتخاب ویژگی را براساس دو معیار تابع تولید کننده و تابع ارزیابی طبقه بندی میکنیم و براساس رویکرد دیگر تکنیک های انتخاب ویژگی را به سه دسته Filter ، Wrapper و embedded or hybrid تقسیم می کنیم.
روش فیلتر Filter برای انتخاب ویژگی:
ویژگی ها را براساس یک مرحله پیش
پردازش که الگوریتم یادگیری را نادیده می گیرد انتخاب میکند. روش فیلتر براساس
ویژگی های ذاتی داده بنا شده است نه
براساس دسته بند خاصی. ذات فیلترها برجستجوی ویژگی های وابسته و حذف غیر وابسته ها
است. الگوریتم های فیلتر بر پایه چهار معیار ارزیابی مختلف به نام های “مسافت
،اطلاعات ،وابستگی و سازگاری” ارزیابی می شوند .به راحتی برای دیتاست های با ابعاد
بالا به کار می روند. از نظر محاسباتی خیلی ساده و سریع هستند و مستقل از الگوریتم
دسته بندی هستند . شیوه کار آنها به این طریق است که ابتدا ویژگی ها را به وسیله
یک سری معیارها امتیازدهی می کند. سپس d تا از بهترین ویژگی ها را انتخاب می
کند. سپس این مجموعه به عنوان ورودی به الگوریتم دسته بندی، داده می شود. به بیان
دیگر به طور مستقل به تک تک ویژگی ها امتیازی داده می شود و سپس براساس آن
امتیازات مرتب می شوند. این امتیازات می توانند نشان دهنده رابطه بین ویژگی و
عنوان کلاس باشند. بدین منظور می توان از تست
t یا تست فیشر استفاده کرد. مشکل رویکرد
فیلتر آن است که رابطه درونی بین ویژگی ها درنظر گرفته نشده و ممکن است مجموعه
انتخابی دارای تعداد زیادی ویژگی وابسته به هم باشد، درنتیجه هدف ما که کاهش ویژگی
تا حد ممکن و حذف ویژگی های غیرضروری است را محقق نمی سازد.
انتخاب ویژگی به روش Wrapper:
این رویکرد مجموعه ویژگی را براساس دسته بندی کننده، انتخاب می کند و این مجموعه را با استفاده از دقت پیش بینی یا میزان خوب بودن خوشه ها امتیازدهی می کند یعنی کلاس بندی را یک جعبه سیاه محسوب می کند و زیر مجموعه ویژگی ها را براساس توان پیش بینی آن ها رتبه بندی می کند. این متد از بعضی استراتژی های جستجو مثل SFS و SBS استفاده می کند. این روش ها به روش های ترتیبی منسوب هستند. در این رویکرد، تمامی زیرمجموعه های ممکن از ویژگی ها درنظر گرفته می شود و با ارزیابی همه حالت ها بهترین آن ها که کمترین خطای عمومی را به همراه دارد انتخاب می شود. این متدها در انواع مسائل قادر به یافتن بهترین پاسخ می باشند. اگرچه ممکن است روش های wrapper نسبت به روش های فیلتر نتایج بهتری را تولید کنند ولی اجرای این روش ها پرهزینه است و در بعضی مواقع که تعداد ویژگی ها زیاد باشد منجر به شکست می شوند. مشکل اصلی روش های بسته بندی پیچیدگی بسیار بالاست که منجر به کنترل ناپذیرشدن مسیر حل مسئله می شود.
روش Embedded برای انتخاب ویژگی:
این مدل از مزایای هر دو مدل قبلی به وسیله استفاده از معیارهای ارزیابی مختلفشان در مراحل متفاوت جستجو سود می برد. در متد embedded جستجو برای یک مجموعه ویژگی بهینه ، درون ساختار دسته بندی کننده قرار دارد. در این رویکرد کنترل انتخاب تعداد مناسب ویژگی مشکل است و معمولا با افزونگی ویژگی ها مواجه می شویم. در اینجا نیز ارتباط بین ویژگی ها نادیده گرفته شده است که باعث مشکلاتی در انتخاب نهایی ویژگی ها می شود.
الگوریتم کلونی مورچه ها-(Ant Colony Algorithm)- ( aco) :
در اين الگوریتم ارتباط حشره ها ميبايست محيط اطراف را به نحوي تغيير دهد كه ساير همنوعانش از تغيير محيط آگاه شوند و پيام مورد نظر حشره را دريافت كنند. يكي از بارزترين مثال ها براي چنين ارتباطي، ريزش ماد هاي شيميايي به نام فرومون به وسيله مورچه ها بر روي مسير حركت است. به اين نحو كه مورچه ها طي حركت، دنبال هاي از فرومون را ترسيم مي كنند و همواره مشتاق به دنبال كردن مسيرهايي هستند كه فرومون بيشتري را داشته باشند. تغيير محيط به منظور ايجاد تغييرات در رفتار از طريق ارتباط به وجود آمده، به نام اصل ا ستيگم رجي معروف است. اين اصطلاح براي اولين بار در سال 1959 و به وسيله زيست شناس فرانسوي به نام پيِرپ ول گراسه براي توضيح رفتار موريانه ها به كار برده شده است. به اين ترتيب، استيگمرجي به معني اشاره (البته غير مستقيم) براي انجام كاري خواهد بود. استيگمرجي پاي هي اصلي بسياري از حركت هاي حشرات به خصوص مورچه هاست. در جوامع مورچه اي، يك مورچه ي خاص به نام ملكه وجود دارد كه فقط مسئوليت تخم گذاري را دارد. در مقابل، ساير مورچه ها عملكرد به طور كامل متفاوتي دارند. مورچه هاي يك مجموعه، خود-ترتيب6 هستند و رفتارهاي پيچيد هي كل مجموعه فقط ناشي از رفتارهاي ساده اي است كه تك تك مورچه ها به صورت خود-ترتيب انجام م يدهند. اين خواص جمعي و فردي به نحوي هستند كه بر روي مسايل مختلف كارآيي مناسبي دارند. به خصوص، هنگامي كه در يك باز هي زماني خاص، برخي از مورچه ها عملكرد مناسبي نداشته باشند، با اين وجود عملكرد كلي مجموعه مناسب خواهد بود.عملكرد مورچ ههاي آرژانتيني در يافتن كوتاه ترين مسير بين لانه و منبع غذايي، بسيار عجيب و حيرت انگيز است. مورچه ي آرژانتيني عملا كور است و به طبع كوتاه ترين مسير براي او مفهومي ندارد و به وسيله او قابل شناخت نم يباشد. اما با وجود چنين كمبودي، توده اي از اين مورچه ها مي توانند با همكاري يكديگر، كوتاه ترين مسير موجود بين لانه و محل مواد غذايي را پيدا كنند. الگوريتم بهينه سازي كُلوني مورچه ها، و يا به اختصار الگوريتم مورچه ها، از رفتار مورچه هاي طبيعي كه در مجموعه هاي بزرگ در كنار هم زندگي م يكنند الهام گرفته شده است. الگوريتم هاي ديگري نيز بر اساس الگوريتم مورچه ها ساخته شده اند كه همگي سامان ههاي چند عاملي1 هستند و عامل ها مورچه هاي مصنوعي يا به اختصار مورچه هايي هستند كه مشابه با مورچه هاي واقعي رفتار مي كنند الگوريتم مورچه ها، يك مثال بارز از هوش جمعي است كه در آن عامل هايي كه قابليت چندان بالايي ندارند، در كنار هم و با همكاري يكديگر م يتوانند نتايج بسيار خوبي به دست بياورند. اين الگوريتم براي حل و بررسي محدوده ي وسيعي از مسايل بهينه سازي به كار برده شده است. از اين ميان مي توان به حل مساله كلاسيك فروشنده دوره گرد و همچنين مساله راهيابي در شبك ههاي مخابرات راه دور اشاره نمود.
مورچه ها چگونه مي توانند کوتاهترين مسير را پيدا کنند
مورچه ها هنگام راه رفتن از خود ردي از ماده شيميايي فرومون(Pheromone) بجاي مي گذارند البته اين ماده بزودي تبخير مي شد ولي در کوتاه مدت بعنوان رد مورچه بر سطح زمين باقي مي ماند. يک رفتار پايه اي ساده در مورچه هاي وجود دارد :
آنها هنگام انتخاب بين دو مسير بصورت احتمالاتي( Statistical) مسيري را انتخاب مي کنند که فرومون بيشتري داشته باشد يا بعبارت ديگر مورچه هاي بيشتري قبلا از آن عبور کرده باشند. حال دقت کنيد که همين يک تمهيد ساده چگونه منجر به پيدا کردن کوتاهترين مسير خواهد شد :
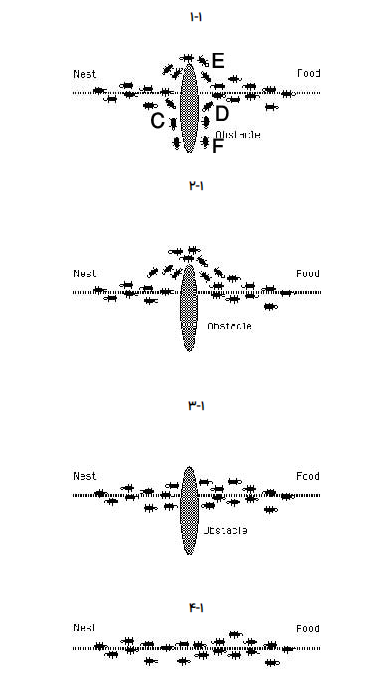
همانطور که در شکل 1-1 مي بينيم مورچه هاي روي مسير AB در حرکت اند (در دو جهت مخالف) اگر در مسير مورچه ها مانعي قرار ديهم(شکل 2-1) مورچه ها دو راه براي انتخاب کردن دارند. اولين مورچه ازA مي آيد و بهC مي رسد، در مسير هيچ فروموني نمي بيند بنابر اين براي مسير چپ و راست احتمال يکسان مي دهد و بطور تصادفي و احتمالاتي مسير CED را انتخاب مي کند. اولين مورچه اي که مورچه اول را دنبال مي کند زودتر از مورچه اولي که از مسير CFD رفته به مقصد مي رسد. مورچه ها در حال برگشت و به مرور زمان يک اثر بيشتر فرومون را روي CED حس مي کنند و آنرا بطور احتمالي و تصادفي ( نه حتما و قطعا) انتخاب مي کنند. در نهايت مسير CED بعنوان مسير کوتاهتر برگزيده مي شود. در حقيقت چون طول مسير CED کوتاهتر است زمان رفت و برگشت از آن هم کمتر مي شود و در نتيجه مورچه هاي بيشتري نسبت به مسير ديگر آنرا طي خواهند کرد چون فرومون بيشتري در آن وجود دارد.
نکه بسيار با اهميت اين است که هر چند احتمال انتخاب مسير پر فرومون ت توسط مورچه ها بيشتر است ولي اين کماکان احتمال است و قطعيت نيست. يعني اگر مسير CED پرفرومون تر از CFD باشد به هيچ عنوان نمي شود نتيجه گرفت که همه مورچه ها از مسيرCED عبور خواهند کرد بلکه تنها مي توان گفت که مثلا 90% مورچه ها از مسير کوتاهتر عبور خواهند کرد. اگر فرض کنيم که بجاي اين احتمال قطعيت وجود مي داشت، يعني هر مورچه فقط و فقط مسير پرفرومون تر را انتخاب ميکرد آنگاه اساسا اين روش ممکن نبود به جواب برسد. اگر تصادفا اولين مورچه مسيرCFD(مسير دورتر) را انتخاب مي کرد و ردي از فرومون بر جاي مي گذاشت آنگاه همه مورچه ها بدنبال او حرکت مي کردند و هيچ وقت کوتاهترين مسير يافته نمي شد. بنابراين تصادف و احتمال نقش عمده اي در ACO بر عهده دارند.
نکته ديگر مسئله تبخير شدن فرومون بر جاي گذاشته شده است. برفرض اگر مانع در مسير AB برداشته شود و فرومون تبخير نشود مورچه ها همان مسير قبلي را طي خواهند کرد. ولي در حقيقت اين طور نيست. تبخير شدن فرومون و احتمال به مورچه ها امکان پيدا کردن مسير کوتاهتر جديد را مي دهند.